機械学習
Machine Learning
機械学習は、データを使ってモデルのパラメーターなどを調整し、新しい入力への予測や分類に利用する技術です。学習したから未知のデータでも必ず正しい、という保証はありません。目的に合う評価が必要です。
🐾 猫で例えると?
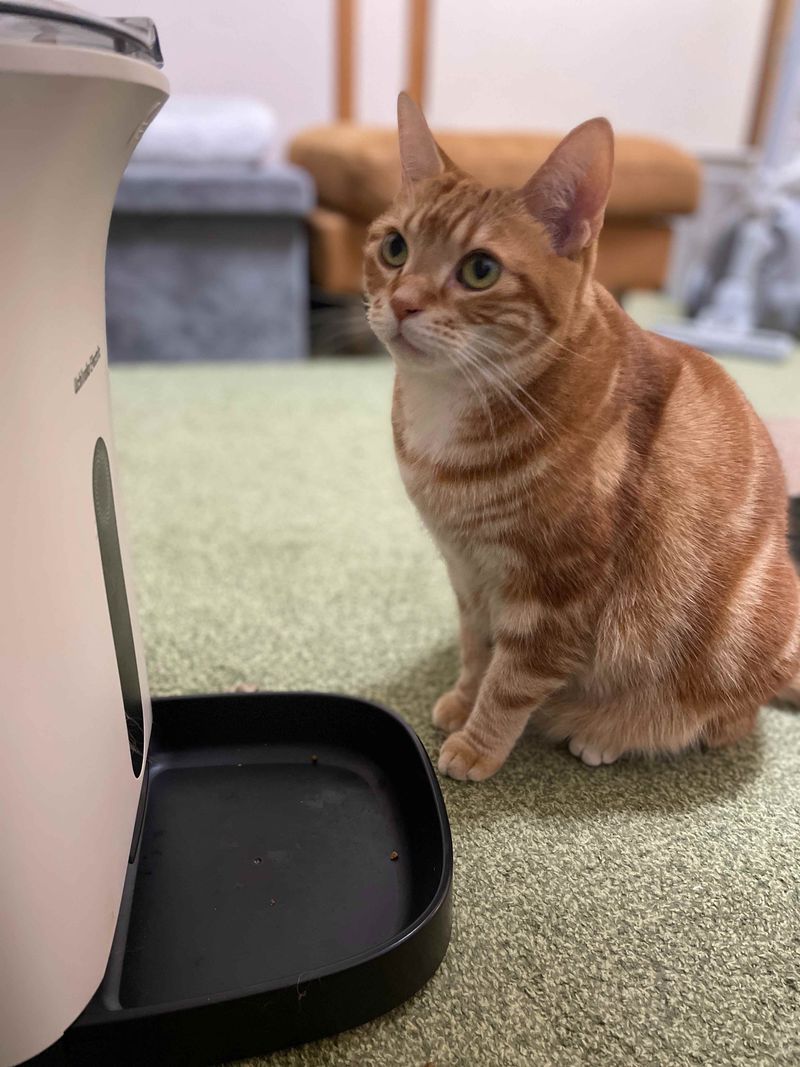
給餌器の前の茶トラを見ると、「そろそろご飯かな?」と待っているようですね。例えば過去にご飯が出た時刻を記録し、次の時刻を予想するなら、過去の記録が学習用データ、そこから得た傾向が予測に使うモデルに当たります。猫の実際の考えとは別に、データから予想を作る流れを覚える例えです。
💻 アプリ・Web開発における「機械学習」とは?
従来のプログラミングでは、開発者が「もしAならBをする」という厳密なルール(条件分岐など)をあらかじめすべて記述する必要がありました。しかし、画像認識や自然言語処理など、ルールを明確に言語化できない複雑なタスクではこの方法(ルールベース)は限界を迎えます。
教師あり学習なら入力と正解例から関係を学び、教師なし学習では正解ラベルを与えず構造を探すなど、目的で方法が異なります。データがあれば何でも自動で解決するわけではなく、入力のどこに注目するかという特徴や、予測のずれを数値にする損失関数、評価方法などを人が設計します。
⚠️ 機械学習の学習手法と注意点
機械学習は、目的や用意できるデータの性質によって「教師あり学習」「教師なし学習」「強化学習」といった手法に分類されます。
モデルの予測モデルを利用するコードの例
次はTensorFlow.jsを読み込んだ環境での模式的な推論例です。入力3特徴・出力1テンソルのLayersModelが指定の場所に存在する前提で、このサイトが猫の行動を予測するモデルを提供するものではありません。数値は架空の入力で、予測精度を示していません。
// TensorFlow.jsのtfが利用可能なasync関数内を想定
const model = await tf.loadLayersModel("/models/example-model.json");
try {
  const output = tf.tidy(() => {
    const input = tf.tensor2d([[0.2, 0.5, 0.1]]);
    return model.predict(input); // この例は単一テンソル出力のモデルが前提
  });
  try { output.print(); }
  finally { output.dispose(); }
} finally {
  model.dispose();
}
学習時と推論時で、特徴の順番、単位、正規化、入力の形を合わせます。出力が数値でも、そのまま信頼できる確率とは限りません。ブラウザーで繰り返し推論する場合は、テンソルなどの後始末と実機での処理時間も確認します。
🛠️ 「機械学習」を賢く使うためのポイント
アプリ開発やビジネスシーンで機械学習を取り入れる際、エンジニアが必ず直面する注意点は以下の通りです。
- 学習に使わないデータで評価: 学習データへ適合しすぎて、新しい入力での成績が下がるのが過学習の問題です。評価用データを学習や前処理の決定へ漏らさず、実際の利用条件に近い分割を考えます。
- データの「質と量」が命となる: 「Garbage In, Garbage Out(ゴミを入れたらゴミが出てくる)」と言われるように、偏ったデータやノイズの多いデータでいくら学習させても、精度の低いモデルしか出来上がりません。収集したデータの偏りや欠損を確認し、目的に合う前処理を行う必要があります。
- 規模に合う方法を選ぶ: 学習に必ず巨大なGPUが必要なわけではありません。簡単なルール、少量の特徴でのモデル、既存モデルやAPIを、精度・遅延・データの扱い・費用で比較します。
給餌器の前で待つ茶トラのように、機械学習は過去のデータから得た傾向を判断に使います。導入時には学習に使っていないデータで評価し、利用する環境でも同じように役立つかを確かめましょう。データの傾向が変わった後の見直しも必要です。