インシデント
Incident
サービスの停止・品質低下や、情報・システムの安全性を脅かすなど、対応が必要な事象を指します。運用とセキュリティでは対象範囲が異なり、実害が確定する前の侵害の疑いも対応対象になります。
🐾 猫で例えると?
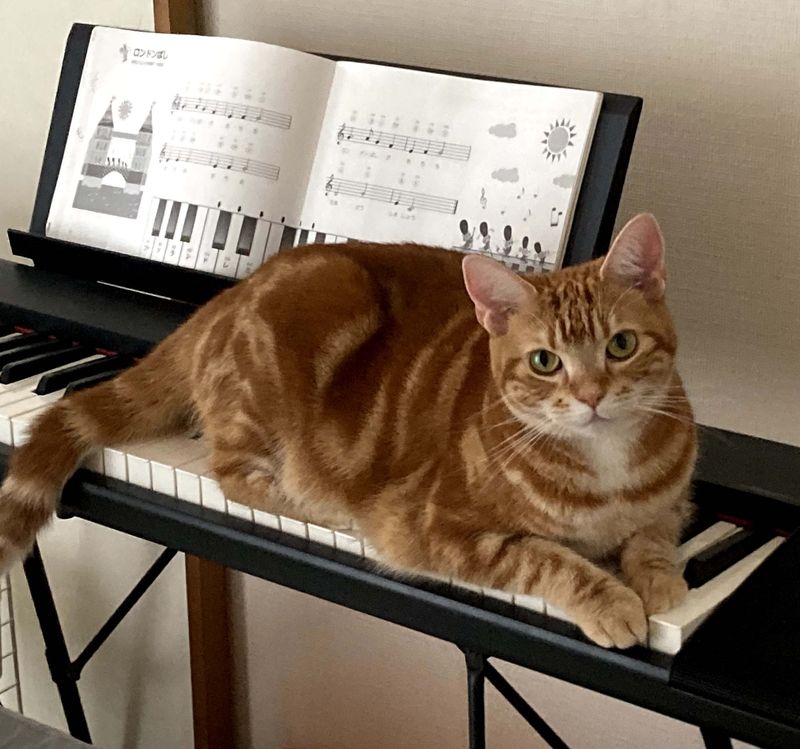
普段は愛嬌たっぷりで癒やしてくれる茶トラですが、時には予期せぬ障害を引き起こすこともあります。楽譜を開いてピアノを弾こうとした矢先、鍵盤の上にどーんと鎮座されて通常業務が完全に中断してしまいました。本来やりたい作業が予期せぬ出来事によって阻害されているこの状態こそがインシデントです。
💻 IT現場における「インシデント」とは?
「決済できない」はサービス運用上のインシデント、「管理者権限が不正に使われた疑い」はセキュリティ上のインシデントの例です。一方、エラーログ一件は調査のきっかけとなるイベントで、直ちに重大事故とは限りません。影響と緊急性を確認して分類します。
対応時は、発見時刻、観測した症状、影響範囲、直前の変更を記録して担当者へ共有します。サービス復旧を優先する状況でも、侵害の疑いがあればログ等の証拠を消さないよう配慮し、封じ込め・調査・復旧を連携して進めます。
⚠️ インシデントの重大度(Severity)分類
現場では、発生したインシデントを「重大度(Severity/セベリティ)」によって分類し、対応の優先順位を決定します。限られたリソース(エンジニアの数)で、最も影響の大きいものから火消しを行うためです。
// インシデントの重大度(Severity)のレベル例
Sev 1 (Critical): サービス全体が停止、または大規模なデータ流出。全社を挙げて即時復旧にあたる。
Sev 2 (High)    : 一部機能が使用不可。主要な業務に大きな影響あり。
Sev 3 (Medium)  : パフォーマンス低下など。回避策はあるが修正が必要。
Sev 4 (Low)     : 軽微な表示崩れなど。一部ユーザーのみに影響。
上のSev 1〜4は一例で、番号や基準は組織ごとに異なります。猫が鍵盤を塞いで演奏できない例も、練習中なのか本番中なのかで影響は変わります。対象人数、重要な業務、データへの影響、回避策の有無を基準に決めておきましょう。
🛠️ インシデント対応のベストプラクティス
インシデントが発生した際に、組織としてどう動くかがエンジニアリングの腕の見せ所です。特に以下のポイントが重要視されます。
- 非難しない文化(Blameless): 原因を作った人を責めるのではなく、なぜシステムがそのミスを許容してしまったのかという仕組みの改善に目を向けます。花瓶を割った猫を怒るより、割れる場所に置いた環境を見直すべきという考え方です。
- 迅速なエスカレーション: 自分だけで直そうと抱え込むと事態は悪化します。茶トラが部屋から飛び出したら、一人で探す前にすぐ家族全員に共有して一斉に捜索するのと同じです。
- ポストモーテム(事後検証)の実施: トラブルが解決して終わりではありません。原因、タイムライン、再発防止策をまとめたドキュメントを作成しチーム全体で知見を共有することで、システムをより強固にしていきます。
茶トラに作業を中断されたときのように、予期せぬ事態ではまず状況を整理します。インシデントでは、発生時刻・影響範囲・行った対応を記録し、決めた連絡先へ共有しましょう。復旧後に記録を振り返ると、次回の検知や対応手順の改善につなげられます。