データマイニング
Data Mining
データマイニングとは、蓄積された大量のデータの中から、統計学や機械学習などの手法を用いて、未知の規則性や隠れた相関関係、価値ある傾向を自動的に探し出す技術のことです。
🐾 猫で例えると?
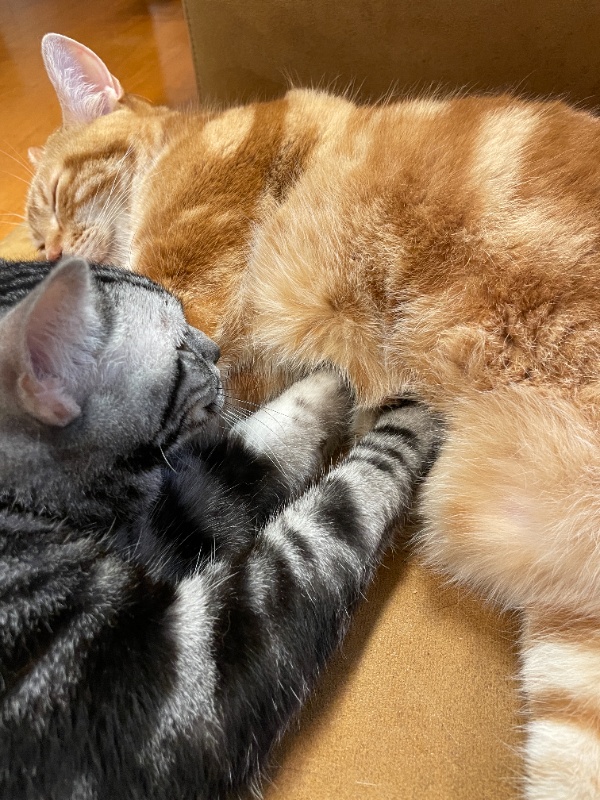
茶トラのお腹へ前足を添えるアメショ。手探りで手掛かりを探す姿を入口に、「たくさんの猫の観察記録から、よく一緒に起きる行動を探す」と考えてみましょう。データマイニングが対象にするのは記録されたデータで、統計などの手法で傾向を調べます。見つかった相関だけで、行動の原因まで確定するわけではありません。
💻 IT現場における「データマイニング」とは?
データマイニング(Data Mining)の「マイニング」は「採掘」を意味します。山のように積まれた土砂の中から砂金を見つけ出すように、一見すると無意味に見える膨大なデータの集まりから、ビジネスの意思決定に役立つ「知見」を掘り起こす作業を指します。
例えば購入記録から「猫砂と一緒に買われる商品」を調べたり、利用履歴から解約しそうな利用者の特徴を探したりします。これは用途を示す架空例です。見つかった傾向は偶然や季節性の影響もあり、別期間のデータや実際の施策で検証します。
⚠️ データマイニングの仕組みと注意点
データマイニングを成功させるためには、いきなり分析を始めるのではなく、事前の準備が非常に重要です。データの中には、入力ミスや欠損値、重複データなどのノイズが大量に含まれています。これらを綺麗に掃除する「データクレンジング(前処理)」を行わなければ、誤った分析結果を導き出してしまいます。
代表的な分析手法
似た特徴を持つ集団を探すクラスタリング、数値を予測する回帰、条件分岐で分類や回帰を行う決定木などがあります。回帰は未来予測だけの方法ではなく、目的に合った入力と評価方法を選ぶことが重要です。
# Python、NumPy、scikit-learn導入済みの環境での例
from sklearn.cluster import KMeans
import numpy as np

X = np.array([[1, 2], [1, 4], [1, 0], [10, 2], [10, 4], [10, 0]])
model = KMeans(n_clusters=2, n_init=10, random_state=0).fit(X)
print(model.labels_)  # 0/1はグループ名。優劣や正解のラベルではない
この例は六つの点を距離に基づいて二群へ分けるものです。K-meansは指定された群数に分けるため、結果が出ただけでは有用な分類とは限りません。特徴量の単位が異なる場合は標準化等を検討し、分け方が目的に合うかを確認します。
🛠️ データマイニングを賢く使うためのポイント
データから有益な情報を得るためには、単に高性能なツールを回すだけでなく、分析結果をどのようにビジネスに活かすかという明確な目的意識が必要です。
- 明確な目的の設定: 何の課題を解決するためにデータを発掘するのか、仮説とゴールを最初に定義することが最も重要です。
- データの品質担保: 分析の精度は入力されるデータの質に依存します。丁寧な前処理(データクレンジング)に十分な時間をかける必要があります。
- 相関と因果の混同に注意: データ上の「AとBが同時に起きる(相関関係)」という結果が、必ずしも「Aが原因でBが起きた(因果関係)」とは限らないため、結果の慎重な解釈が求められます。
アメショがふみふみしながら居場所を探るように、データマイニングも結果を確かめながら傾向を探します。「一緒に増えた」ことが「一方が原因」という意味にはなりません。何を判断したいかを決め、欠損や偏りを確認してから、見つけた関係を解釈しましょう。