スクレイピング
Web Scraping
プログラムを用いてWebサイトのHTMLソースを解析し、特定のデータや必要な情報だけを自動的に抽出・収集する技術。
🐾 猫で例えると?
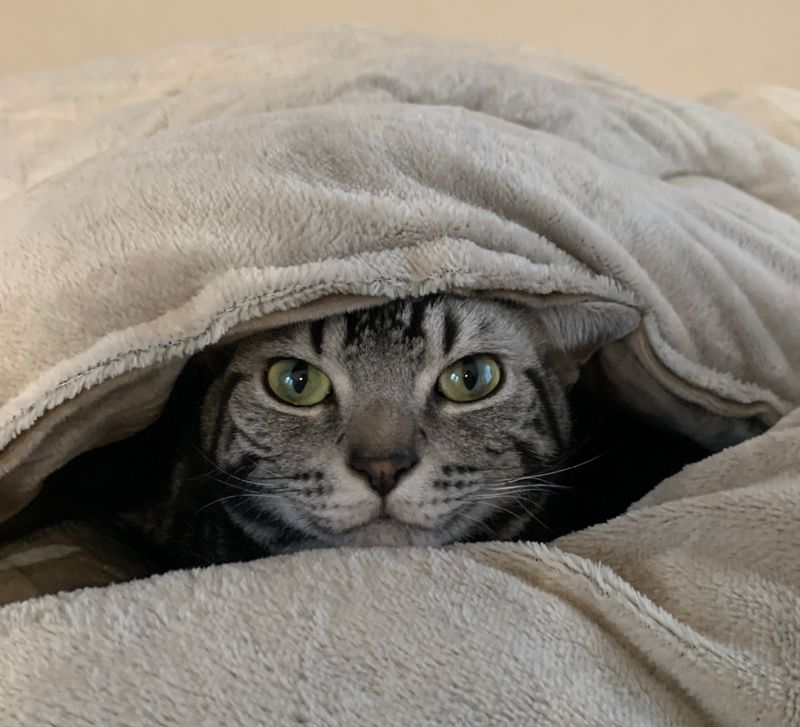
アメショが布団の隙間に深く潜伏し、じっとこちらを監視しています。この鋭い眼光は、部屋全体の景色から「飼い主の特定の動き」や「おやつの位置」といった重要なターゲット情報だけを正確に解析し、抽出しているかのようです。無駄な情報を削ぎ落とし、お目当てのデータだけをロックオンしてスキャンする姿は、まさに効率的なスクレイピング処理そのものです。
💻 IT現場における「スクレイピング」とは?
スクレイピングは、Webページから必要な情報を取り出して整理する手法です。手作業を減らせますが、HTMLの変更、通信エラー、取得制限への対応も必要です。継続運用では、取得件数や失敗を確認する仕組みも用意します。
PythonではRequestsでHTMLを取得し、Beautiful Soupで解析する組み合わせがよく使われます。ただし、JavaScript実行後に表示される情報は、取得したHTMLに含まれない場合があります。まず公式APIやデータ配布の有無を調べると、安定した取得方法を選びやすくなります。
⚠️ スクレイピングの仕組みと注意点
スクレイピングは強力な反面、実務で導入する際には技術面・法律面・倫理面で非常に厳しい制約と注意点が存在します。一歩間違えると、損害賠償請求やサイバー攻撃とみなされるリスクがあります。
Webサイトにかける負荷と利用規約の壁
以下はネットワークへ接続せず、手元のHTMLから商品名を抽出する最小例です。Python環境にbeautifulsoup4をインストールして実行します。
from bs4 import BeautifulSoup

html = '<ul><li class="product">猫じゃらし</li><li class="product">猫のベッド</li></ul>'
soup = BeautifulSoup(html, "html.parser")
for item in soup.select(".product"):
    print(item.get_text(strip=True))
実際のサイトへアクセスする場合は、利用条件やrobots.txtを確認し、リクエストの間隔・上限・タイムアウトを設定します。取得済みHTMLを解析するループで待つだけでは、HTTPリクエストの集中を防げません。待機や再試行の制御は通信処理に対して行います。
🛠️ スクレイピングを安全に運用するためのポイント
トラブルを避け、法的なリスクを回避しながらスクレイピングを賢く使うためのベストプラクティスです。
- robots.txtを確認する:クローラーに対するアクセス方針を示す仕組みです。アクセス認証ではなく、記載がないことが取得・再配布の許可を意味するわけでもありません。
- APIが提供されている場合はAPIを使う: 対象サイトが公式にデータを取得するためのAPIを公開している場合は、スクレイピングを避け、規約に則ったAPI経由でのデータ取得を優先します。
- 取得と再利用を分けて考える:公開情報でも自由な転載や個人情報の収集が認められるとは限りません。目的、取得量、保存内容、公開方法に応じて利用条件や適用されるルールを確認します。
布団の隙間から様子をうかがうアメショのように、取得を始める前に対象サイトの条件を確認します。公式APIがあれば先に検討し、HTMLを取得する場合もアクセス間隔や変更への対応を決めましょう。取得できることと、再配布・再利用できることは別に確認する必要があります。