フェイルオーバー
Failover
フェイルオーバーとは、稼働系に障害が起きたとき、別の系へ処理を引き継ぐことです。自動で行う構成も、確認後に手動で行う構成もあり、停止時間やデータの損失をどこまで許容するかに合わせて設計します。
🐾 猫で例えると?
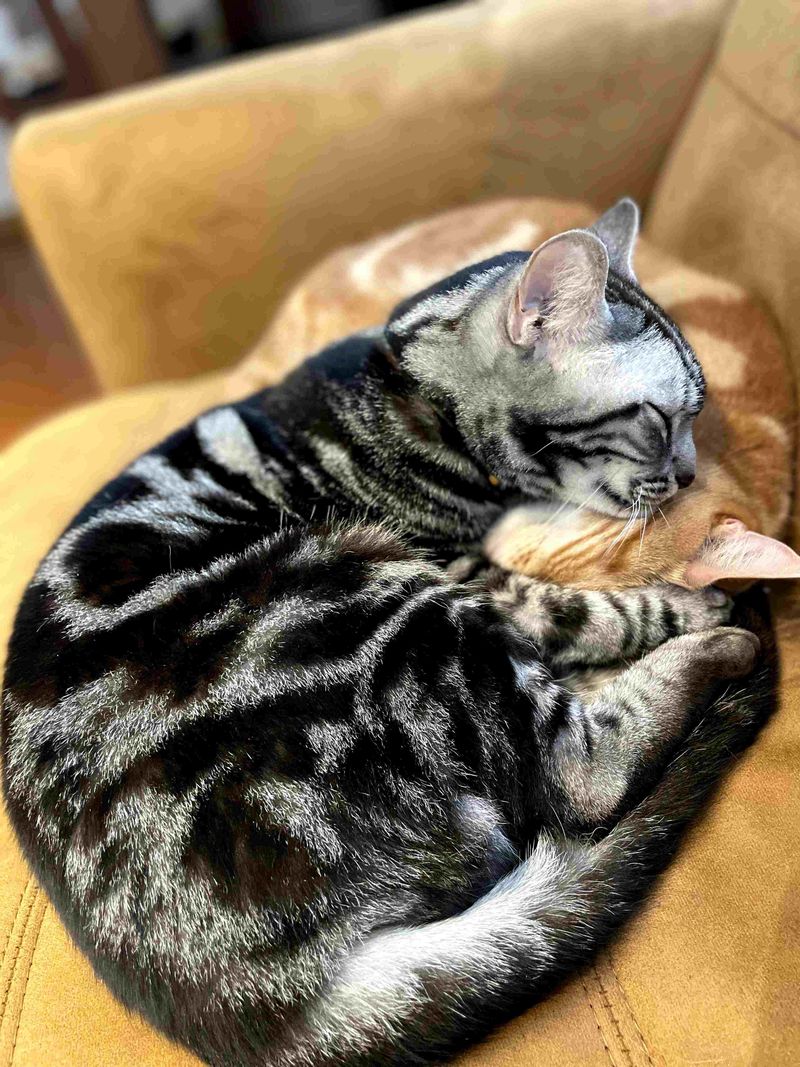
茶トラに前足を添えるアメショは、頼もしい相棒のよう。茶トラが休む間、お出迎えの役をアメショが引き継ぐ、と想像するとフェイルオーバーのイメージになります。システムでも役割を引き継げるように、データや接続先を切り替える準備が必要です。
💻 IT現場における「フェイルオーバー」とは?
「絶対に止まってはいけないシステム」において、サーバーが1台だけというのは非常にリスクが高い状態です。もしその1台が故障すれば、サービスは即座に停止し、売上損失やユーザーの信頼喪失につながります。そのため、現場では同じ構成のサーバーを2台以上用意し、片方が倒れてももう片方がすぐに引き継げるような「冗長化(じょうちょうか)」という構成をとります。
自動切り替えでは、監視の失敗が続いた場合などに障害を判定します。通信が一度途切れた瞬間に無条件で切り替えると、誤検知や二重稼働につながります。判定、昇格、接続の張り直しに時間がかかり、実行中の処理が失敗する場合もあります。
⚠️ フェイルオーバーの注意点
フェイルオーバーは非常に強力な仕組みですが、単純に2台にすればいいというものではありません。
// フェイルオーバーの設計ポイント
- ハートビート監視: 相手が生きているか常に確認する
- データの同期: メイン機のデータを常に予備機へコピーしておく
- スプリットブレイン: 両方が「自分がメインだ」と勘違いし、データが矛盾する現象
通信が分断され、両方が主系として書き込む状態をスプリットブレインと呼びます。多数決で判断するクォーラムや、旧主系を確実に切り離すフェンシングなどが対策になります。また、非同期複製では切り替え時に未反映の更新を失う可能性があります。
🛠️ 切り替え後まで確認する
冗長な機器を置くだけでなく、切り替えに何秒かかるか、どの処理が再試行されるか、旧主系をどう復帰させるかまで確認します。通常系へ戻すフェイルバックは、別の計画として慎重に行います。
- 定期的な切り替え訓練: 本番環境で故障が起きた時に本当に自動切り替えが動くか、定期的にテスト(フェイルオーバーテスト)を行うことが最も重要です。
- 監視の目を光らせる: 切り替えが起きる前の予兆(負荷の急増やエラーの増加)を検知し、先回りしてフォローできる体制を整えましょう。
茶トラをアメショが支えるように、予備の系が引き継ぐ準備をしておくのがフェイルオーバーです。切り替え手段を用意したら、利用者が再び操作できるまでの時間と、引き継がれるデータを試験で確かめましょう。故障した系を戻す手順も含めて運用を決めます。