Algorithm & UI/UX
AIで「主役」を際立たせる:背景エフェクトの技術解剖
人物をカラーのまま残し、背景だけを白黒やぼかしに変換する「マジックカラー」処理。この体験をブラウザ上で完結させるため、WebAssemblyを用いた高速セグメンテーションと、Canvas 2D APIを駆使した「擬似ボケ」アルゴリズムを導入しています。
このツールの入力から出力まで
現行コードの確認日:
- 入力
- 人物写真を選び、背景側の彩度などを調整します。
- 処理
- 人物マスクから残す側を決め、人物の色を維持しながら背景を加工した画像を合成します。
- 出力
- 長辺1500px以下へ縮小し、JPEG品質0.95で出力します。
まず確認する点:主役の判断は人物モデルによる推定です。ペットや商品を同じように検出する前提にせず、マスクの境界と残したい物を見ます。
仕上がりの例
人物の色を残し、背景を白黒にした例です。
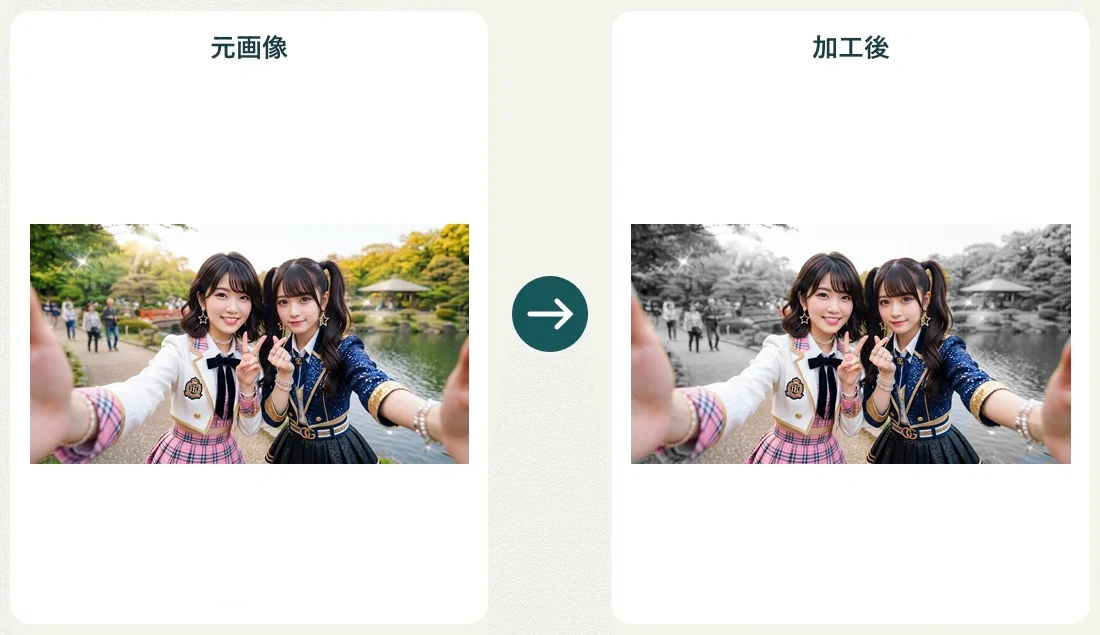
サンプルにはAIで生成した架空の人物画像を使用しています。
掲載画像はサイトにある既存の公開作例です。保存済みの資料ではAIで作成した架空の人物・手の画像を使用しています。今回の確認日が、この作例を実行した日を表すわけではありません。
保存済み検証記録の条件を見る
資料の種類は「ツールの出力画像を保存した記録」です。公開作例と保存済み記録で素材や色などが異なる場合があるため、下の数値は保存済み検証記録の条件として読んでください。
- 記録の入力画像
- 1788×2400px (JPEG)
- 記録の出力画像
- 1117×1500px (JPEG)
| 画面の項目 | 記録の値 | 現行コードの初期値・範囲 |
|---|---|---|
| 記録で選択されていた項目 | 🌗 白黒 | — |
| エフェクトの強さ | 100 | 初期値 100 / 範囲 0〜100 |
記録では「この画像で保存へ進む」から完成表示へ進んでいます。初期値と記録値を比べてから、効果を1項目ずつ変えると作用を確認しやすくなります。
資料ファイルの作成日は実行日として扱っていません。個別端末の処理速度や、ほかの写真に対する検出・加工の精度を測定した資料でもありません。
実装の確認箇所:src/pages/ai/ima-seg/magic-color/index.astro。以下のコード抜粋と出力条件は、この本番実装に基づいて説明します。
仕組みを読み進めるときは、MediaPipeの画像セグメンテーション(人物マスクの寸法、カテゴリと資源解放)、Canvas APIと画像処理(画像寸法、drawImage、画素と透明度の扱い)が参考になります。
1. Composite Operation による非破壊クリッピング
AIが生成した人物のマスクデータ(2値画像)を使って、元の画像から人物だけを抜き出す処理。本ツールではCanvasの合成モード(Composite Operation)を利用して、マスクと元画像の重なる部分を残します。GPUを使うかどうかはブラウザの実装に依存します。
source-in を利用することで、「先に描画したマスク画像」が不透明な部分にのみ「後から描画した元画像」を表示させることができます。これにより、マスクに残した範囲の画素を合成できます。髪などの細い境界を正しく分類できるかは、AIの推定結果に依存します。
白黒モードの1画素分の処理です。strengthは0〜100で、元のRGBと輝度から作った灰色を混ぜます。
function mixGray(rgb, strength) {
  const gray = rgb[0] * 0.299 + rgb[1] * 0.587 + rgb[2] * 0.114;
  return rgb.map(value => value + (gray - value) * strength / 100);
}
2. スパイラル・オフセット法による「軽量ぼかし」
Canvas標準のぼかしフィルタは環境によって重くなることがあるため、背景のぼかしには独自の「多重オフセット描画」を採用しました。
画像を一旦1/5程度に縮小して描画負荷を下げた後、黄金角に基づく回転式を用いて、少しずつ位置をずらしながら数十回重ね描きします。これにより、ずらした画像を重ねて周囲の色を混ぜます。光学レンズのボケやガウスぼかしと同じ計算ではなく、処理時間は端末に依存します。
3. 端末内完結(Edge AI)のパイプライン
プライバシー保護のため、画像の解析からエフェクト適用まで、すべての処理が「ユーザーの端末内」で実行されます。MediaPipeのモデルをWebAssembly経由で動作させ、requestAnimationFrameで未実行の描画予約を整理します。推論や画素計算そのものはメインスレッドで行うため、大きな写真でも操作が止まらないことを保証する仕組みではありません。
出力の仕様と確認する点
マスクの大きさは返却されたwidth・heightを参照します。readMaskDataで処理Canvasの寸法へ合わせ、カテゴリは最近傍補間で所有配列へコピーします。コピー後にImageSegmenterResult.close()で元のマスク資源を解放し、編集と描画にはコピーを使います。
白黒・セピア・ぼかしを背景に適用します。白黒とセピアの強さは元の色との混合率、ぼかしの強さは36回重ね描きする位置の広がりを変えます。ぼかし用画像は縦横20%へ縮小して使います。
現行のMediaPipe Tasks Vision 0.10.34とselfie_segmenter.tfliteのカテゴリマスクは、人物が0、背景が255です。背景のカテゴリ255へ効果を掛け、人物のカテゴリ0を残します。髪と背景を誤分類した場合には、残したかった部分にも効果が掛かることがあります。
長辺1500px以下へ縮小し、JPEG品質0.95で出力します。白黒化は情報を隠す処理ではなく、ぼかしでも文字や場所が識別できる場合があるため、公開用の画像は結果を確認してください。